Arbeitsplatz für einen Großhändler: Ein selbst betriebenes Vision-Sprachmodell liest Bestellungen, das Team prüft sie am Original und exportiert sie als CSV.
Ausgangslage
Bei einem Großhändler gehen Bestellungen in vielen Formen ein: als PDF, Scan, Fax, Foto oder handschriftlicher Zettel, auf Deutsch, Englisch und Französisch. Kundennummer, Bestellnummer, Artikelnummern und Mengen wurden bisher von Hand übertragen.
Ein Vision-Sprachmodell, das auf einem eigenen GPU-Server im Haus läuft, liest diese Dokumente seitenweise aus: Kopfdaten und Positionen. Das Ergebnis wird mit den Stammdaten abgeglichen, also mit Kundenliste, Artikelstamm und EAN-Zuordnung. Wo etwas nicht passt, entsteht eine Warnung, etwa bei einem mehrdeutigen Artikel, einer ungültigen Prüfziffer, einer unplausiblen Menge oder einer doppelten Bestellnummer. Ein Cloud-Dienst für Sprachmodelle ist nicht im Spiel.
Was fehlte, war der Arbeitsplatz dazu: eine Oberfläche, in der das Team die erkannten Bestellungen prüft, korrigiert und weitergibt, und eine Datenhaltung, die beides verbindet.
Meine Rolle
Von mir stammen der Arbeitsplatz im Browser, die Datenbasis, über die er mit der Erkennung zusammenarbeitet, und die Installation auf dem Server des Kunden. Die Erkennung selbst, also Modell, Prompts, Stammdatenabgleich und E-Mail-Eingang, hat ein Kollege entwickelt.
Umsetzung
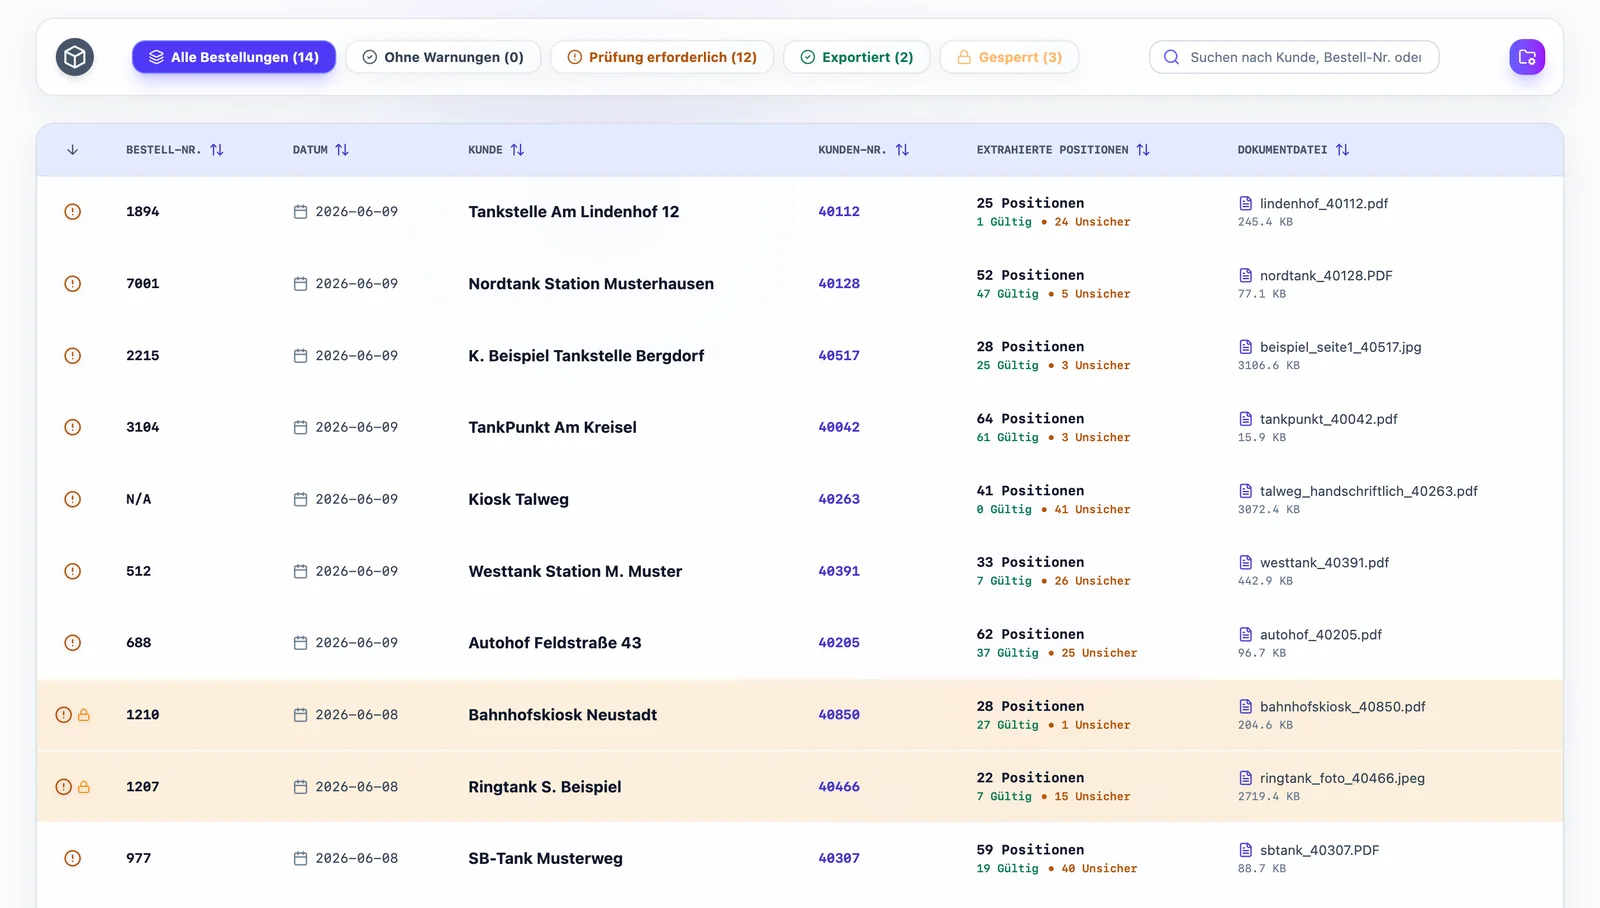
- Posteingang: Alle erkannten Bestellungen stehen in einer Liste mit Reitern nach Zustand: ohne Warnungen, Prüfung erforderlich, exportiert, gesperrt. Sie lässt sich durchsuchen, sortieren und mit Mehrfachauswahl bearbeiten; Dubletten sind unter ihrem Original gruppiert. Neue Dokumente erscheinen ohne Neuladen in allen geöffneten Fenstern.
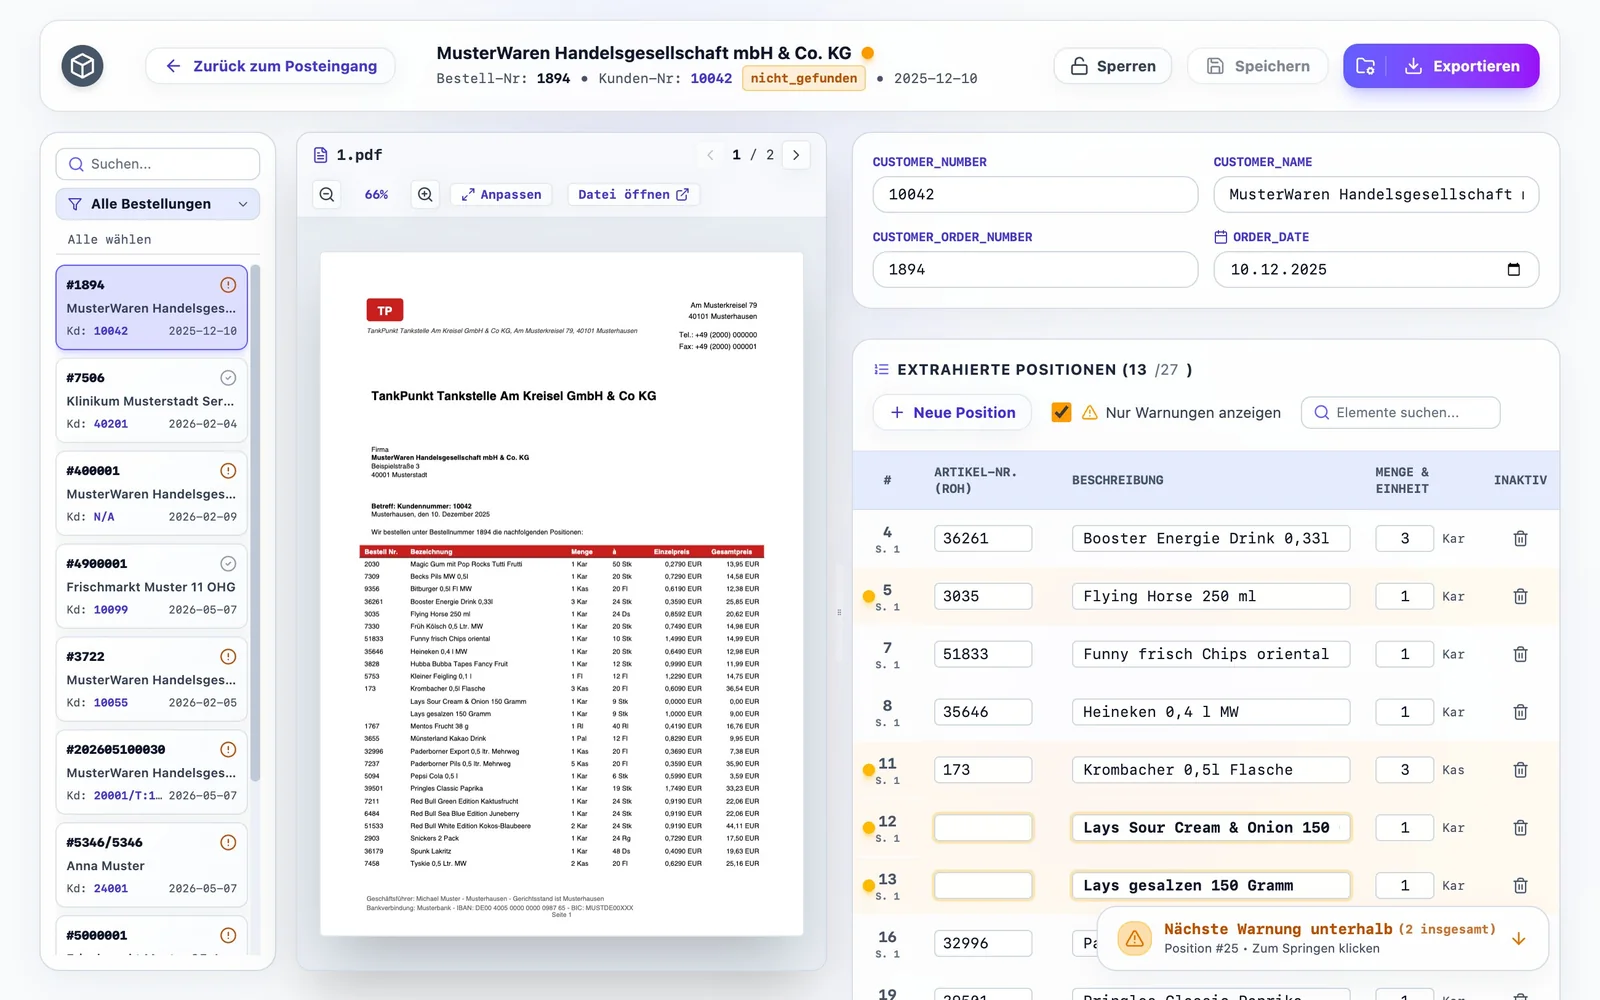
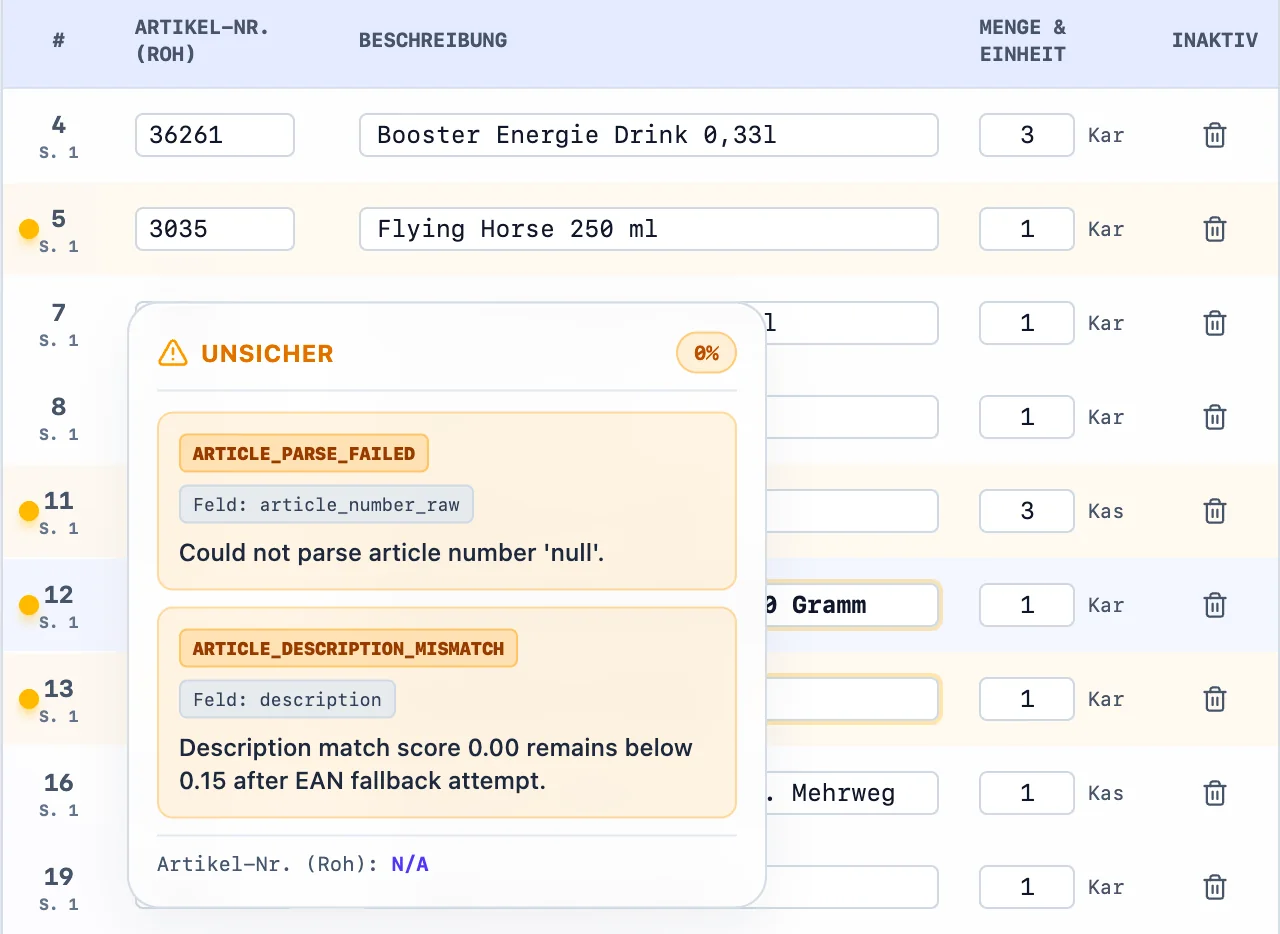
- Prüfansicht: Links steht das Originaldokument mit Zoom von 5 bis 500 Prozent, rechts stehen Kopfdaten und Positionen; jede Position springt per Klick auf ihre Seite. Die Kopfzeile zeigt, ob die Kundennummer in den Stammdaten gefunden wurde, und bei Bestellungen per E-Mail den Absender. Die Tabelle zeigt zunächst nur Positionen mit Warnung, eine schwebende Schaltfläche führt zur nächsten, und ein Popover nennt Art, Feld und Trefferquote des Abgleichs.
- Korrekturen ohne Verlust: Der erkannte Wert bleibt erhalten, die Korrektur wird daneben gespeichert und lässt sich zurücknehmen. Positionen lassen sich ergänzen und deaktivieren. Solange eine Rückfrage beim Kunden läuft, lässt sich eine Bestellung sperren; Bearbeitung und Export sind dann für alle gesperrt.
- Export: Jede Bestellung wird als CSV-Datei in einen gewählten Ordner geschrieben und gilt erst als exportiert, wenn die Datei tatsächlich vorliegt. Ein erneuter Export muss bestätigt werden, und die Dateien lassen sich gefahrlos in Tabellenprogrammen öffnen.
- Datenbasis: Erkennung und Arbeitsplatz arbeiten auf derselben Datenbasis, eine Bestellung hat daher überall denselben Status. Fällt die Datenbank aus, bleibt die Anwendung lesend verfügbar.
- Betrieb: Neue Versionen kommen fertig gebaut auf den Server des Kunden, Quellcode liegt dort nicht. Für Vorführungen gibt es eine eigene Fassung mit zehn anonymisierten Beispielbestellungen, die keinen Zugriff auf echte Daten hat.
Ergebnis
Die Anwendung ist auf einem Server im Haus des Kunden installiert und wird von der Erkennung befüllt. Bestellungen ohne Warnung lassen sich direkt exportieren; bei den übrigen führt die Oberfläche zu den Stellen, die eine Entscheidung brauchen. Die Dokumente verlassen dabei das eigene Netz nicht.
Ein ähnliches Projekt geplant?
Im Gespräch klärt sich, ob und wie sich Ihr Vorhaben umsetzen lässt – mit einer ersten Einschätzung zu Umfang und Zeitrahmen.